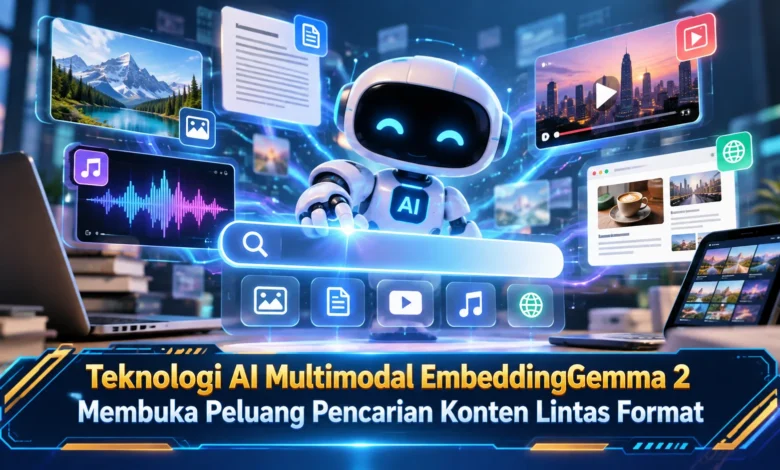
Google DeepMind memperkenalkan EmbeddingGemma 2 pada 6 Oktober 2026 sebagai model kecerdasan buatan multimodal yang dirancang untuk memahami hubungan antara teks, gambar, audio, video, dan kode pemrograman. Inovasi ini menjadi perkembangan penting dalam teknologi pencarian semantik karena memungkinkan berbagai format informasi dipetakan ke dalam satu ruang representasi digital. Dengan ukuran model yang relatif ringan, EmbeddingGemma 2 juga mendukung pemrosesan langsung pada perangkat seperti laptop dan smartphone. Kemampuan tersebut membuka peluang pengembangan aplikasi pencarian yang lebih fleksibel, termasuk penelusuran foto menggunakan kalimat, pencarian adegan video, serta pengelolaan dokumen berdasarkan makna tanpa selalu bergantung pada layanan cloud.
Perkembangan Teknologi Embedding AI melalui Model EmbeddingGemma 2
EmbeddingGemma 2 merupakan model representasi informasi lintas format yang dirancang untuk menghubungkan berbagai jenis informasi digital ke dalam ruang representasi bersama. Dibandingkan dengan model embedding yang hanya memahami tulisan, EmbeddingGemma 2 dapat menghasilkan representasi dari teks, gambar, audio, video, dan kode. Melalui pendekatan tersebut, tim teknologi bisa mengembangkan sistem penelusuran konten yang lebih fleksibel. Sebagai contoh, pertanyaan tentang pemandangan laut dapat digunakan untuk mencari foto yang memiliki keterkaitan makna. Inovasi tersebut mempermudah penelusuran informasi melalui deskripsi alami.
Tim pengembang Google memperkenalkan EmbeddingGemma 2 pada 6 Oktober 2026 sebagai generasi berikutnya teknologi embedding ringan. Model terdahulu dirancang terutama untuk representasi bahasa, sedangkan pembaruan terbaru menghadirkan pemrosesan informasi multimedia. Dalam pengumumannya, model generasi pertama telah mencatat lebih dari 20 juta unduhan. Perkembangan tersebut menjadi salah satu dasar bagi penyempurnaan kemampuan multimodal. Berkat pendekatan pengembangan terbuka, Google memberikan kesempatan bagi komunitas pemrograman untuk menguji kemampuan representasi data sesuai lingkungan komputasi.
Cara Kerja Teknologi EmbeddingGemma 2 dalam Memahami Berbagai Format
Dasar teknologi EmbeddingGemma 2 adalah menghasilkan vektor yang menggambarkan karakteristik informasi. Hasil pemetaan ini dikenal sebagai embedding yang dapat digunakan untuk mengukur kedekatan makna antarobjek. Melalui sistem Google tersebut, teks dan media visual diubah menjadi representasi yang kompatibel dengan representasi standar sebanyak 768 dimensi. Melalui pendekatan tersebut, pertanyaan tertulis dapat dibandingkan dengan gambar tanpa mengandalkan deskripsi manual untuk setiap berkas. Pendekatan pemetaan ini membantu menghubungkan informasi yang memiliki struktur data tidak seragam.
Ketika aplikasi menerima permintaan, EmbeddingGemma 2 mengubah permintaan menjadi representasi semantik. Pada tahap berikutnya, mesin pencarian menghitung kedekatan representasi dengan vektor gambar dan media pada basis data. Konten yang memiliki kemiripan lebih tinggi bisa diprioritaskan dalam daftar hasil. Dalam skenario penggunaan, pengguna mengetik kalimat tentang kendaraan merah dan sistem dapat menemukan foto yang relevan meskipun nama file tidak mengandung kata tersebut. Meskipun pencarian berbasis embedding cukup fleksibel, pengukuran vektor tetap memiliki kemungkinan kesalahan. Untuk memperoleh hasil yang baik, aplikasi membutuhkan pengaturan indeks yang sesuai.
Arsitektur Modular EmbeddingGemma 2 dengan Model Hingga 740 Juta Parameter
Daya tarik arsitektur EmbeddingGemma 2 adalah rancangan modular. Arsitektur yang dikembangkan Google memanfaatkan fondasi arsitektur Gemma 4 dengan model teks dan kode sekitar 270 juta parameter. Untuk mendukung informasi visual, pengembang dapat menambahkan encoder vision sebesar 170 juta parameter sehingga ukuran sistem menjadi sekitar 440 juta parameter. Di sisi pemrosesan suara, modul pemrosesan suara sebesar 300 juta parameter dapat diaktifkan sesuai kebutuhan sehingga jumlah parameter menjadi sekitar 570 juta. Untuk penggunaan multimodal penuh, jumlah parameter keseluruhan menjadi 740 juta. Strategi pemuatan komponen membantu menyesuaikan sumber daya perangkat.
Selain memiliki struktur modular, EmbeddingGemma 2 memanfaatkan Matryoshka Representation Learning atau MRL yang memungkinkan penyesuaian panjang embedding. Berkat mekanisme tersebut, hasil numerik berdimensi 768 dapat dipersingkat menjadi 512, 256, atau 128 dimensi. Pilihan tersebut bermanfaat untuk biaya penyimpanan representasi konten. Dalam penerapan praktis, sistem pencarian berisi banyak foto dapat mempertimbangkan dimensi lebih kecil agar beban penyimpanan dapat ditekan. Walaupun penghematan cukup menarik, pengurangan dimensi dapat memengaruhi kualitas pencarian. Karena itu, pengembang perlu membandingkan hasil sebelum menggunakan ukuran vektor tertentu.
Penerapan EmbeddingGemma 2 bagi Aplikasi Pencarian Lintas Format
Manfaat praktis EmbeddingGemma 2 adalah pengembangan pencarian foto berbasis bahasa alami. Dalam aplikasi penyimpanan foto, ribuan berkas mungkin sulit ditemukan. Berkat kemampuan pemetaan lintas format, pemilik aplikasi dapat mencari berdasarkan konteks seperti pemandangan matahari terbenam di pantai. Mesin penelusuran tersebut membandingkan makna pertanyaan dengan representasi gambar untuk menampilkan gambar yang paling relevan. Fungsi pencarian tersebut dapat mengurangi kebutuhan penandaan manual. Namun demikian, hasil tidak selalu sempurna.
Tidak terbatas pada konten visual diam, EmbeddingGemma 2 dapat digunakan untuk pencarian konten audiovisual. Untuk ilustrasi, pengguna dapat mencari adegan video berdasarkan kalimat yang menggambarkan isi adegan. Kemampuan multimodal tersebut mendukung penilaian kemiripan teks dengan bingkai video. Dalam pengolahan suara, deskripsi seperti suara hujan deras dapat digunakan sebagai kueri. Pendekatan tersebut berpotensi membantu jurnalis dalam mengurangi pencarian manual. Namun demikian, kualitas pencarian dipengaruhi cara media diindeks. Dengan perancangan yang tepat, aplikasi mampu memberikan pengalaman lebih baik.
EmbeddingGemma 2 Mendukung AI Lokal dan Sistem RAG yang Lebih Fleksibel
Salah satu fokus pengembangan EmbeddingGemma 2 adalah mendukung pemrosesan langsung pada perangkat. Google merancang agar penggunaan memori bisa disesuaikan. Berdasarkan evaluasi perangkat Google, konfigurasi teks tertentu memerlukan sekitar 191 MB memori aktif, sedangkan penggunaan semua jenis media dilaporkan menggunakan kurang lebih 567 MB memori aktif. Hasil pengukuran ini memberikan gambaran optimasi pada lingkungan pengujian tertentu. Meskipun kebutuhan memorinya relatif rendah, hasil penggunaan pada laptop atau smartphone lain dapat berbeda. Di samping kebutuhan RAM, performa bergantung pada akselerator yang tersedia.
Arsitektur ringan EmbeddingGemma 2 juga memberikan manfaat dalam sistem Retrieval Augmented Generation atau RAG. Sistem pengambilan informasi untuk AI memanfaatkan hasil penelusuran dokumen dengan sistem AI yang menyusun jawaban. Dalam proses tersebut, EmbeddingGemma 2 membantu menentukan dokumen yang perlu diambil, sedangkan asisten AI menggunakan konteks yang ditemukan. Sebagai contoh, materi pelatihan serta rekaman dapat dihubungkan melalui basis data vektor. Pengguna kemudian, bisa mengajukan pertanyaan menggunakan deskripsi kebutuhan. Namun demikian, penyimpanan informasi sensitif perlu dilindungi. Dengan penerapan yang bertanggung jawab, AI lokal dapat menjadi alternatif menarik.
Kesimpulan tentang EmbeddingGemma 2 dan Masa Depan Pencarian Multimodal
Kehadiran EmbeddingGemma 2 memperlihatkan inovasi bermanfaat dalam pemrosesan informasi digital lintas format. Melalui penyatuan teks gambar audio video dan kode, pengembang dapat membangun penelusuran berdasarkan makna. Selain itu, arsitektur modular memberikan fleksibilitas pengembangan. Walaupun demikian, hasil pencarian tetap membutuhkan evaluasi sehingga pemilihan parameter perlu dilakukan dengan tepat. Melalui penggunaan yang terencana, EmbeddingGemma 2 mampu mendukung pengembangan layanan digital pada berbagai jenis perangkat. Dari sudut pandang Anda, apakah teknologi embedding multimodal akan mengubah cara kita menemukan informasi? Jangan ragu menyampaikan pengalaman Anda mengenai masa depan pengelolaan informasi digital.